2026 年 9 月 16 日晚,我的腾讯云轻量服务器在跑了半年各种自托管应用之后,终于在一个平常的晚上彻底卡死。这篇文章完整记录了从排查崩溃原因、发现入侵痕迹、清除后门到加固重建的全过程。如果你也在一台小内存 VPS 上跑一堆容器,希望这篇复盘能帮到你。
背景#
这台服务器配置并不富裕:
- 2 核 CPU / 3.6GB 内存,4GB swap,50GB 磁盘
- Ubuntu 24.04,腾讯云轻量
- 上面跑着 Coolify 全家桶(约 20 个 Docker 容器):Vaultwarden、Memos、OpenGist、Uptime Kuma、Chronoframe、Artalk、ClickHouse、OpenList 等等
- 之前还装过 MCSManager 面板管理 MC 服务器
崩溃那晚的现象很典型:SSH 登录极慢,响应卡顿,最终负载飙到了 353(对一台 2 核机器来说这个数字是灾难性的),iowait 高达 31%,swap 全满,机器基本处于瘫痪状态。只能通过腾讯云控制台强制重启。
第一步:确定崩溃原因#
SSH 终于挤进去之后,先用 sar(sysstat 记录的历史数据)回溯了崩溃时间段的负载曲线,然后用 journalctl 和 dmesg 查 OOM 记录,真相很快浮出水面:
- chronoframe 容器是主犯。这个图片墙应用(Node.js)RSS 峰值达到 ~2.4GB,在一台 3.6GB 内存的机器上完全没有内存上限约束
- 它在崩溃前已经被 OOM killer 反复击杀过多次(exit 137,分别在 9/14、9/16 两次崩溃当天)
- 崩溃当天 20:59,chronoframe 再次触发 OOM,swap 全满,负载雪崩到 353
- 另外 Coolify 自带的 Horizon 常年吃掉约 93% 的单个核心,让本就紧张的资源雪上加霜
结论:一台 3.6GB 内存的机器,跑了 20 个无内存限制的容器,OOM 是必然的,只是时间问题。
但排查到这里,真正的"惊喜"还在后面。
第二步:意外的发现——挖矿木马#
顺着排查系统状态,我在 systemd 单元列表里发现了几个不该存在的东西:
xmrig.service           —  XMRig 挖矿木马,每 10 秒重启一次
tianji-reporter.service —  可疑的"监控上报"服务
tianji-telemetry.service —  每 60 秒向 localhost:12345 上报的 Python 脚本
xmrig.service 的重启计数已经达到 10.8 万次——意味着它每 10 秒失败重试一次,持续了 12 天。因为二进制文件早已被删除(后来确认是腾讯云镜在安装后不久自动隔离了它),systemd 只能无限空转。
入侵链条还原#
结合 /var/log/auth.log 和 journalctl 的记录,完整入侵链条如下:
- 2026-08-16 22:26 — 攻击者(IP
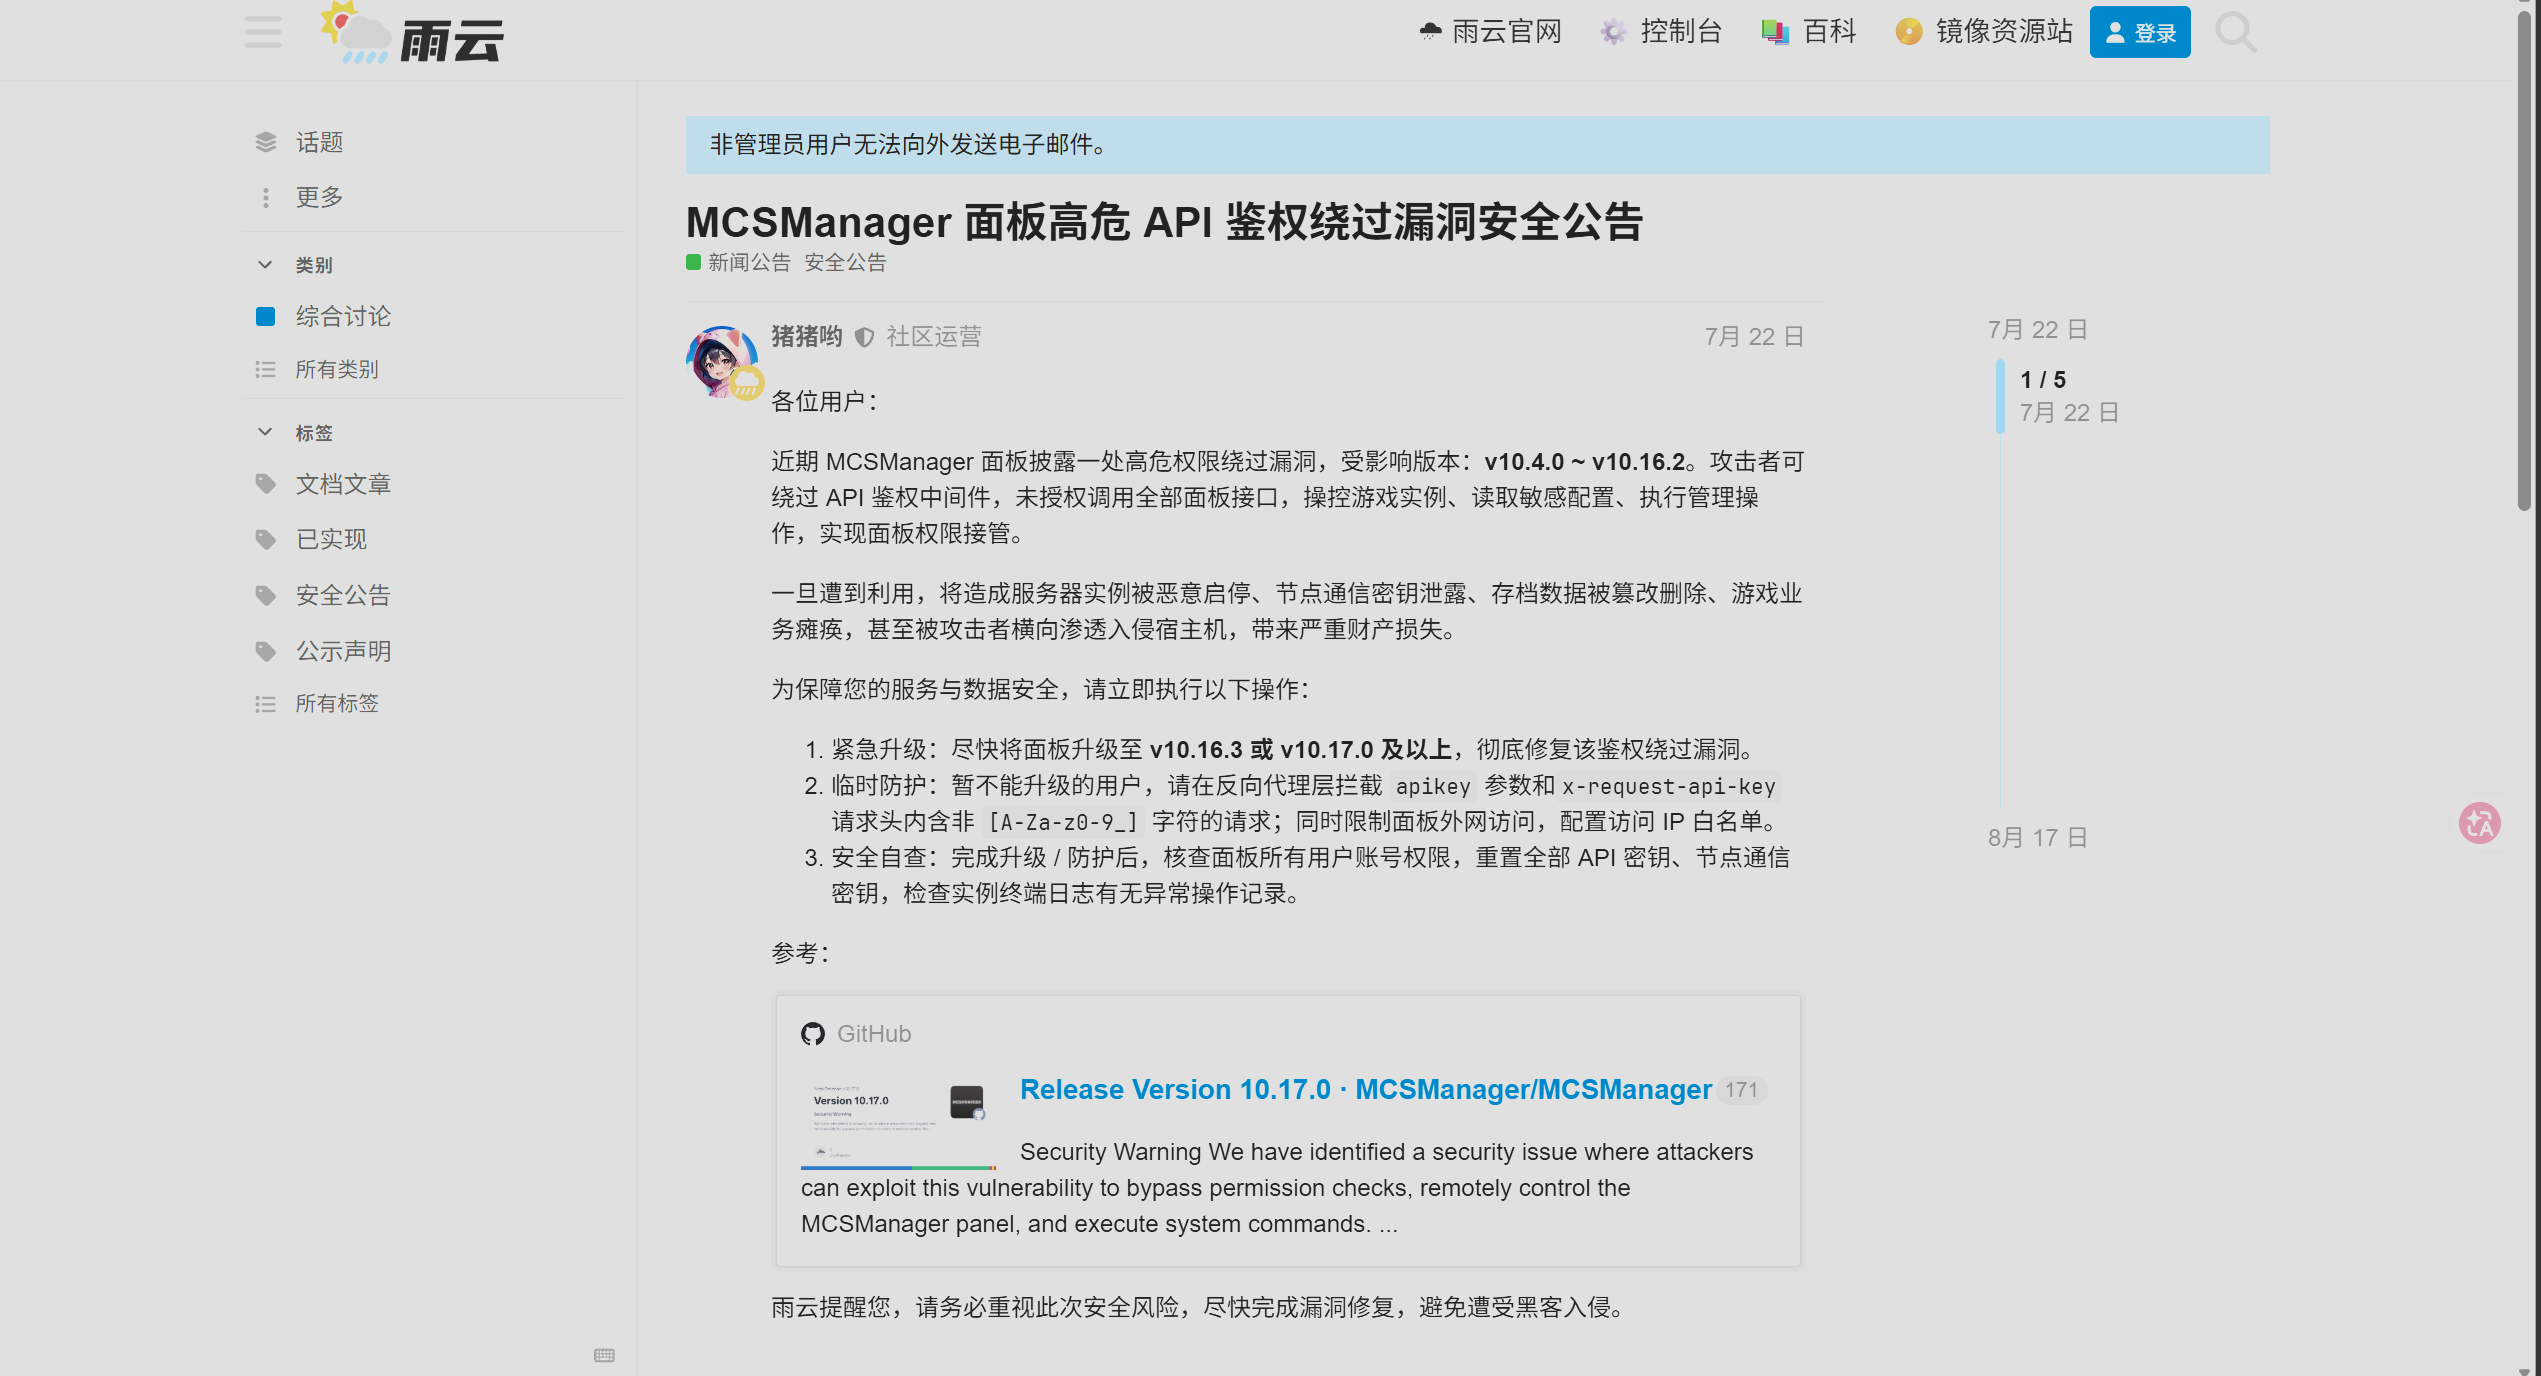
23.156.153.36)通过 MCSManager 注册了用户名123456的账号 - 23:13 — 利用 MCSManager v10.4.0 ~ v10.16.2 的 API 鉴权中间件绕过漏洞(未授权即可调用全部面板接口),将
123456提权为权限 10 的管理员 - 23:15 — 通过面板自带的终端功能拿到实例 shell,进而提权到 root
- 23:16 — 下载 XMRig 6.21.3 到
/123/xmrig-6.21.3,安装xmrig.service,配置矿池auto.c3pool.org:23333,注入 Monero 挖矿地址 - 当晚 CPU 负载飙到 68%,XMRig 成功运行了一段时间,直到云镜把它隔离
事后我去确认了这个漏洞——MCSManager 官方早已发布公告,v10.16.2 及以下版本全部中招,我的面板版本 v10.16.2 正好是"临门一脚"。
更早的痕迹#
另外 SSH 上的情况也很糟糕:root 密码登录对公网暴露,每周 1.2 万+ 次爆破尝试。排查期间就亲眼看到两个陌生 IP 在 preauth 阶段反复试探。
第三步:清理#
确认入侵后,清理工作分三批进行:
1. 移除攻击入口#
systemctl stop mcsm-daemon.service mcsm-web.service
systemctl disable mcsm-daemon.service mcsm-web.service
rm -rf /opt/mcsmanager
# 删除 unit 文件,daemon-reload
端口 23333/23334 清空,进程无残留。
2. 停掉所有容器#
20 个容器全部 docker stop。这一步顺带把内存压力释放了——swap 用量归零,为后续操作腾出了安全空间。
3. 清除恶意持久化#
systemctl stop/disable xmrig tianji-reporter tianji-telemetry
rm -f /etc/systemd/system/xmrig.service \
      /etc/systemd/system/tianji-reporter.service \
      /etc/systemd/system/tianji-telemetry.service \
      /usr/lib/systemd/system/tianji-reporter.service
rm -rf /123
rm -f /usr/local/bin/tianji-report.py /etc/tianji-reporter.json
systemctl daemon-reload && systemctl reset-failed有个小插曲:tianji-reporter.service 在 /usr/lib/systemd/system/ 还有一份,第一轮清理漏掉了,systemctl list-unit-files 又冒出来一次,补删之后才彻底干净。云镜隔离区里的 xmrig 二进制保留在 /usr/local/qcloud/YunJing/quara/ 作为取证证据。
第四步:全面后门排查#
清完已知后门,还要确认攻击者没有留下其他"礼物"。逐项过了一遍:
| 排查项 | 结果 |
|---|---|
| 账户/sudo | ✅ 仅 root/ubuntu/lighthouse,无多余 uid 0,passwd/shadow/sudoers 6 月后未改动 |
| cron | ✅ 仅腾讯云 agent 和自己的脚本 |
| systemd 单元 | ✅ 除已清除的 3 个外无其他自定义单元 |
| authorized_keys | ✅ 仅 coolify 和自己的密钥,无攻击者公钥 |
| SUID 文件 | ✅ 无异常(容器快照内的属正常) |
| deleted-but-running 二进制 | ✅ 无 |
| /etc/ld.so.preload | ✅ 空 |
| /etc/hosts、LD_PRELOAD、profile.d、rc.local | ✅ 干净 |
| /tmp /var/tmp /dev/shm 可执行文件 | ✅ 无 |
| dpkg 完整性 | ✅ 仅 sudoers md5 变化(自己配的 NOPASSWD) |
| Docker 镜像 | ✅ 无挖矿镜像 |
| /root 近期文件 | ✅ 都是自己装的 1Panel 和运维脚本 |
7 月 28 日至 9 月初系统目录里变更的一批二进制(systemd、curl、openssl、dockerd 等)核对了 apt 历史记录,均为 unattended-upgrades 的正常更新。结论:除已知三处外,没有发现其他后门。
第五步:加固重建#
排查完毕后做了三件事:
fail2ban#
# /etc/fail2ban/jail.d/sshd.local
[sshd]
enabled = true
maxretry = 5
findtime = 10m
bantime = 1h
bantime.increment = true
bantime.maxtime = 48h
装完即生效,10 分钟内就记录了 16 次爆破失败——这台机器每天都在被打。
Swap 4G → 8G#
swapoff /swap.img
dd if=/dev/zero of=/swap.img bs=1M count=8192
chmod 600 /swap.img && mkswap /swap.img && swapon /swap.img
在容器全部停止、内存压力释放的状态下操作,很安全。
容器恢复 + 内存限制#
全部容器 docker start。中间踩了个坑:clickhouse 容器启动失败报 no such volume——服务器崩溃时 Docker 的 volume 元数据丢了,但 /var/lib/docker/volumes/ 下的数据目录还在。docker volume create 重建同名 volume 注册后数据完好,容器正常启动。
最后给 OOM 主犯 chronoframe 加上内存上限:
docker update --memory 1536m --memory-swap 2g chronoframe-xxx注意 docker update 在 Coolify 重新部署时可能被覆盖,需要同步在应用配置里设置。
复盘总结#
后记
从来没有想到过说mcsm竟然会爆这么大个漏洞
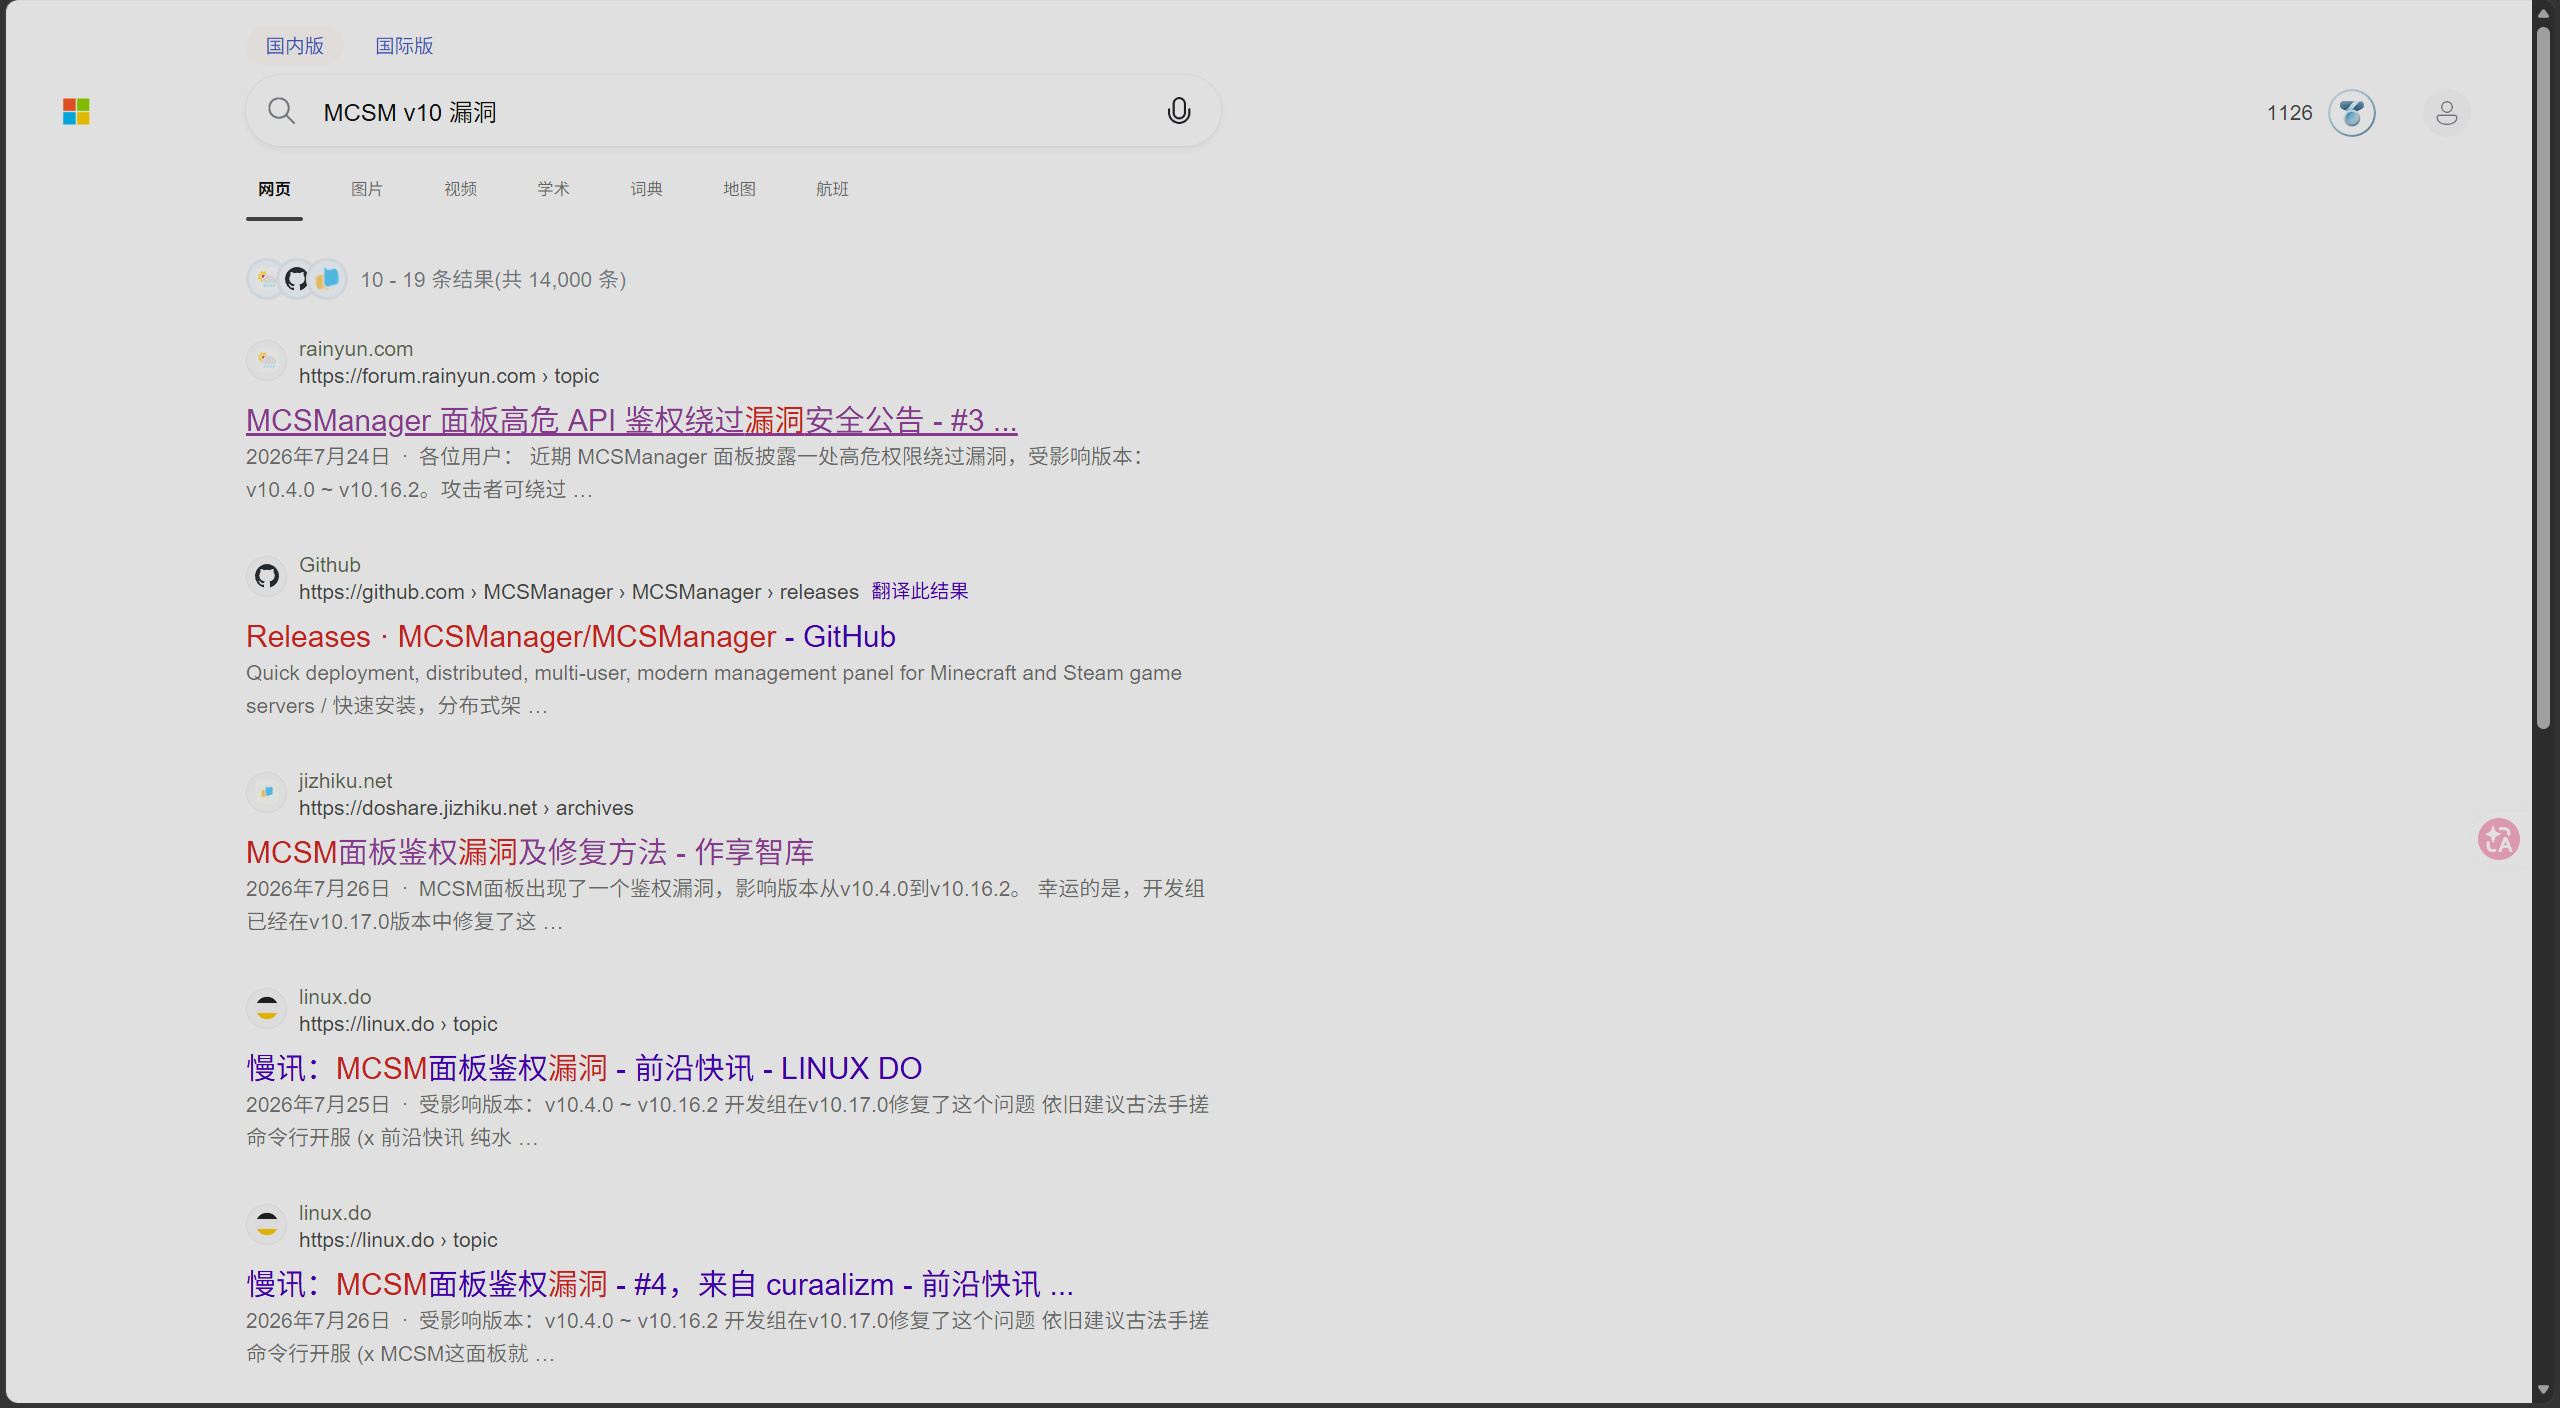
而更让我惊讶的是,网上竟然没多少有关这条漏洞的信息!甚至是GLM-5.3-Flash说到mcsm被入侵的路径我查关键词才找到的!
官方更逆天,就发了个Release:https://github.com/MCSManager/MCSManager/releases/tag/v10.17.0,没有经过Security模块,没分配CVE,没有经过足够长的时间再公开漏洞(当然我估计也不会有多少人有更新的习惯),不管怎么说这种做法总归有点不对,还是那句话:建议手打命令行开服(
这次事件的根本原因#
- 安全意识盲区:MCSManager 是个暴露公网的面板,我既没跟进它的安全公告,也没及时升级——漏洞公告就在那里,只是我没看
- 资源超卖:3.6GB 内存跑 20 个无限制容器,OOM 是时间问题
- SSH 配置裸奔:root + 密码登录 + 公网暴露 = 每天被爆破
我学到的教训#
- 凡是暴露公网的 Web 服务,都要当作随时会被打穿来对待。订阅你所用软件的安全公告,或者至少定期检查版本
- 小内存机器一定要给每个容器设 memory limit。一个失控的容器能拖死整台机器,OOM 时 kernel 杀进程是随机的,可能杀掉你最重要的那个
- fail2ban 是 SSH 的最低配置,成本几乎为零
- systemd 单元是后门重灾区。排查入侵时
systemctl list-unit-files配合文件创建时间是性价比最高的第一步 - 日志会轮转丢失。重要时间段的日志要在排查时立刻备份,
journalctl -b -1能救急但不是万能的
还没做完的(下一步计划)#
- SSH 改为仅密钥登录,更换 root 密码
- 1Panel(5227 端口)和 Docker swarm 端口(2377/7946)加防火墙白名单
- Coolify 里给所有常驻应用补上 memory limit 配置
一台 2 核 3.6GB 的机器上堆满了自托管服务,安全上又有暴露的面板和裸奔的 SSH——这个组合出事只是时间问题。希望这篇复盘能让读到的人少踩一些坑。
(文中 IP、矿池地址等信息仅用于还原事件,请勿用于任何非法用途。)